前言
Kafka 是一個分散式流處理平台,主要用於實現高吞吐量、低延遲的資料傳輸。它的核心概念是將資料以「事件流」的形式儲存和傳遞,讓不同系統之間可以即時同步資料。
CDC (Change Data Capture) 是一種捕獲資料庫變更的技術,透過監聽資料庫的異動紀錄(如 MySQL 的 binlog),將每一筆 INSERT、UPDATE、DELETE 即時發送到 Kafka 中。
背景
這次藉由 Table 的變更來實作 CDC, 在多環境的 RBAC 中,使用者對角色新增 要手動新增到其他環境, 這個過程是重複的,且容易出錯 為了解決這個問題,我們可以利用 Kafka 的 CDC 功能,將使用者對角色新增的變更,發送到 Kafka 中,把變更同步到其他環境。
實作
1. 各服務介紹
這次實作的架構如下:
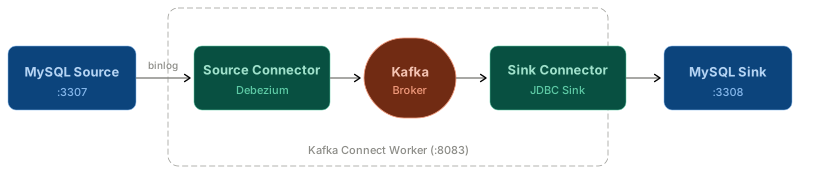
Database:
- Source DB — 模擬 Production Database
- Sink DB — 模擬 Development Database
Service:
- Kafka Broker — 儲存 CDC 變更事件的訊息佇列
- Kafka Connect Worker — 一個獨立的 JVM 服務,專門負責在 Kafka 和外部系統之間搬資料。它本身不是 Kafka Broker 的一部分,而是透過 REST API (port 8083) 管理上面跑的 Connector
- Connector — 基於 Kafka Connect 的 plugin,這次用到兩種:
io.debezium.connector.mysql.MySqlConnector(Source Connector)— 讀取 MySQL binlog,將變更寫入 Kafka Topicio.debezium.connector.jdbc.JdbcSinkConnector(Sink Connector)— 從 Kafka Topic 讀取資料,寫入目標 MySQL
2. 啟動順序
因為服務之間有依賴關係,啟動順序很重要:
- MySQL Source + MySQL Sink — 資料庫先起來
- Kafka Broker — CDC 訊息的儲存中心
- Kafka Connect Worker — 需要 Kafka + 兩個 MySQL 都 ready
- Kafka UI(選用)— 瀏覽器管理介面,方便觀察 topic 和 message
3. 建立 CDC 環境(假設 DB 已存在)
Step 1: 在 Source DB 建立 Debezium 專用帳號
Debezium 需要特定的 MySQL 權限來讀取 binlog:
CREATE USER IF NOT EXISTS 'debezium'@'%' IDENTIFIED BY 'debezium';

GRANT SELECT, RELOAD, SHOW DATABASES, REPLICATION SLAVE, REPLICATION CLIENT
    ON *.* TO 'debezium'@'%';

FLUSH PRIVILEGES;
各權限的用途:
SELECT— 做 initial snapshot 時需要讀取表資料RELOAD— 執行 FLUSH 指令(取得一致性 snapshot)SHOW DATABASES— 探索 database 結構REPLICATION SLAVE— 讀取 binlog(CDC 核心功能)REPLICATION CLIENT— 查詢 binlog 位置(SHOW MASTER STATUS)
另外 Source MySQL 必須開啟 binlog 相關設定(在 Docker Compose 中透過 command 參數設定):
command:
  - --server-id=1
  - --log-bin=mysql-bin
  - --binlog-format=ROW       # 記錄每一行的變更(不是 SQL 語句)
  - --binlog-row-image=FULL   # 記錄完整的 before/after 資料
Step 2: 在 Sink DB 建立對應的表結構
Sink DB 需要有跟 Source 一樣的表結構(不需要資料),資料會由 CDC 同步過來:
CREATE TABLE new_users (
    id INT AUTO_INCREMENT PRIMARY KEY,
    email VARCHAR(255) NOT NULL UNIQUE,
    display_name VARCHAR(255) NOT NULL DEFAULT '',
    full_name VARCHAR(255) NOT NULL DEFAULT '',
    title VARCHAR(100) DEFAULT NULL,
    dept VARCHAR(100) DEFAULT NULL,
    status SMALLINT NOT NULL DEFAULT 1,
    created_at TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP,
    updated_at TIMESTAMP NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
Step 3: 註冊 Source Connector
Connector 的設定寫在 JSON 檔中,透過 Kafka Connect REST API 註冊:
curl -X POST -H "Content-Type: application/json"
  -d @connectors/source-mysql.json localhost:8083/connectors
Step 4: 註冊 Sink Connector
curl -X POST -H "Content-Type: application/json"
  -d @connectors/sink-mysql.json localhost:8083/connectors
可以先只註冊 Source Connector,去 Kafka UI 確認 topic 有收到 message 後,再註冊 Sink Connector。
4. Kafka 核心概念
Topic
Topic 是 Kafka 中訊息的分類。Debezium Source Connector 會自動建立 topic,命名規則是:
{topic.prefix}.{database}.{table}例如 topic.prefix: "source" + database bi_portal + table new_users → source.bi_portal.new_users
Partition
Partition 是把一個 topic 的資料切成多份的機制。它的目的有兩個:
- 平行處理 — 不同 partition 可以分配給不同 consumer
- 保證順序 — 同一個 partition 內的 message 會維持寫入順序
每個 topic 至少有 1 個 partition。
Topic: source.bi_portal.new_users(3 個 partition)

  Partition 0: [msg1, msg4] → Consumer 1 (Group A)
  Partition 1: [msg2, msg5] → Consumer 2 (Group A)
  Partition 2: [msg3]       → Consumer 3 (Group A)
也可以把關係想成這樣:
Topic
  ├─ Partition 0 ──> Group A / Consumer 1
  ├─ Partition 1 ──> Group A / Consumer 2
└─ Partition 2 ──> Group A / Consumer 3重要:1 partition -> 1 consumer 的限制是針對「同一個 Consumer Group」內。
- 同一個 Group 內 — 一個 partition 同一時間只會分配給 1 個 consumer(為了保證消費順序)
- 不同 Group 之間 — 每個 group 都可以各自讀同一個 partition
同一個 Partition 0:

  Group A / Consumer 1 → 讀得到
  Group A / Consumer 2 → 讀不到(同 group,已分配給 Consumer 1)
  Group B / Consumer 1 → 讀得到(不同 group,各自獨立消費)
對照圖如下:
                Topic / Partition 0
                       │
         ┌─────────────┴─────────────┐
         │                           │
     Group A                     Group B
         │                           │
  Consumer 1  <- 分配到         Consumer 1  <- 也可讀
  Consumer 2  <- 不會讀到
所以如果 topic 只有 1 個 partition,同一個 group 內開再多 consumer 也沒用,只有 1 個會真的在讀,其他會閒置。要提高同 group 的平行度,就要增加 partition 數量。
Message 的 Key 和 Value
每筆 Kafka message 由兩部分組成:
| 部分 | 說明 |
|---|---|
| Key | 識別值,Debezium 用表的主鍵當 key |
| Value | 實際的 CDC 資料(before、after、op) |
Key 的作用:
- 決定進哪個 partition — 同一個 key 永遠進同一個 partition,保證同一筆資料的操作順序不會亂
- Log compaction — Kafka 可以只保留每個 key 的最新一筆 message
- Sink 對應 —
primary.key.mode: record_key讓 Sink 知道要 upsert 哪筆資料
CDC 操作類型(op)
Debezium 的 message value 中,op 欄位代表操作類型:
| op | 說明 |
|---|---|
c | create(INSERT) |
u | update(UPDATE) |
d | delete(DELETE) |
r | read(initial snapshot) |
Consumer 和 Consumer Group
Sink Connector 註冊後,Kafka Connect 會自動建立一個 Consumer Group(名稱為 connect-{connector名稱}),訂閱指定的 topic 並開始消費 message。
查看消費進度:
# 在 Kafka UI → Consumers 看 Lag
# Lag = 0 代表全部處理完了

# 或用指令
docker exec kafka /opt/kafka/bin/kafka-consumer-groups.sh
  --bootstrap-server localhost:9092
  --group connect-sink-mysql-connector
  --describe
5. Initial Snapshot
Debezium 設定 "snapshot.mode": "initial" 時,首次啟動會先把 Source DB 現有的資料全部讀一遍寫進 Kafka topic,之後才切換成即時監聽 binlog。
為什麼需要?因為 binlog 只記錄「變更」,不記錄「現有資料」。沒有 snapshot 的話,Debezium 啟動前就存在的資料,Kafka 裡永遠不會有。
如果確定只要「從現在開始」的變更,可以改成 "snapshot.mode": "schema_only"(只讀表結構,不讀資料)。
6. Source Connector 設定重點
{
  "topic.prefix": "source",
  "database.include.list": "bi_portal",
  "table.include.list": "bi_portal.new_users,bi_portal.roles,...",
  "snapshot.mode": "initial",
  "include.schema.changes": "true"
}table.include.list— 只有列在這裡的表,binlog 變更才會送進 Kafka,其他表會被忽略include.schema.changes— 設true會建一個以topic.prefix命名的 topic(如source)記錄 DDL 變更,設false則不會。不影響 CDC 功能
更細的過濾選項:
| 設定 | 作用 |
|---|---|
column.include.list | 只傳指定欄位 |
column.exclude.list | 排除指定欄位(如密碼) |
Debezium 無法在 Source 端過濾操作類型(INSERT/UPDATE/DELETE 都會送出),需要在 Sink 端用 SMT 過濾。
7. Sink Connector 設定重點
{
  "insert.mode": "upsert",
  "primary.key.mode": "record_key",
  "delete.enabled": "true",
  "schema.evolution": "none",
  "transforms.unwrap.delete.handling.mode": "none"
}
insert.mode: upsert— 有就更新,沒有就新增schema.evolution— 控制是否自動 ALTER TABLE:none— 不動表結構,表要自己先建好basic— 自動加欄位(如__deleted)
delete.handling.mode的三種模式:
| 模式 | 行為 |
|---|---|
drop | 忽略 delete 事件,Sink 不做任何事 |
rewrite | 不刪資料,加 __deleted 欄位標記(軟刪除) |
none | 搭配 delete.enabled: true,真的刪 Sink 的資料 |
8. 重播 Message
如果 Sink 資料需要重建,可以重播 Kafka topic 裡的 message:
# 1. 刪掉 Sink Connector
curl -X DELETE localhost:8083/connectors/sink-mysql-connector

# 2. 清空 Sink DB 資料
# 3. 用新名字重新註冊(才能拿到新的 consumer group,offset 從頭開始)
注意:同名字重建的話,offset 還是存在
_connect_offsetstopic 裡,會從上次消費的位置繼續。換名字才能真正從頭重播。
9. Debezium 自動建立的 Topic
| Topic | 內容 | 需要關注 |
|---|---|---|
source.bi_portal.new_users | new_users 的 CDC 資料 | 是 |
source.bi_portal.roles | roles 的 CDC 資料 | 是 |
source | DDL 變更紀錄 | 否(Debezium 內部用) |
_schema_history | DDL 歷史追蹤 | 否(Debezium 內部用) |
_connect_configs/offsets/statuses | Kafka Connect 內部狀態 | 否 |
10. 常用 Debug 指令
# 查看 connector 狀態
curl -s localhost:8083/connectors/source-mysql-connector/status | python3 -m json.tool
curl -s localhost:8083/connectors/sink-mysql-connector/status | python3 -m json.tool

# 查看 Kafka Connect 日誌
podman logs --tail 50 kafka-connect
podman logs kafka-connect 2>&1 | grep -i error

# 查看 Source / Sink DB 資料
docker exec mysql-source mysql -uroot -proot bi_portal -e 'SELECT * FROM new_users;'
docker exec mysql-sink mysql -uroot -proot bi_portal -e 'SELECT * FROM new_users;'

# 刪除 connector(重新設定時用)
curl -X DELETE localhost:8083/connectors/source-mysql-connector
curl -X DELETE localhost:8083/connectors/sink-mysql-connector